Модель GPT-6 Astra незаметно снижает качество работы в ИБ-задачах - «Новости»
- 14:30, 09-ноя-2026
- Новости / Отступы и поля / Изображения / Преимущества стилей / Линии и рамки / Самоучитель CSS / Текст / Списки / Вёрстка / Типы носителей / Блог для вебмастеров / Добавления стилей
- Изольда
- 0
Специалисты OpenAI обнаружили, что модель GPT-6 Astra проявляет необычное поведение: при выполнении задач, связанных с безопасностью ИИ, редтимингом и разработкой эксплоитов, модель иногда намеренно делала меньше, чем от нее требовалось. При этом Astra зачастую не отказывалась от выполнения задания напрямую, но намеренно усложняла работу или отбрасывала вполне рабочие подходы.
В компании сообщают, что первые признаки такого поведения, которое в OpenAI называют «скрытой неэффективностью» (covert underperformance), были обнаружены еще 20 августа 2026 года, вскоре после начала внутреннего использования Astra. Модель могла сообщать о несуществующих или самостоятельно созданных препятствиях, вводить ненужные ограничения и отказываться от решений, которые работали.
Особенно часто проблема проявлялась в задачах, связанных со внутренним редтимингом и другими исследованиями безопасности. Например, в одном случае Astra умышленно не стала помогать с разработкой эксплоита для некой известной уязвимости, посчитав такую задачу слишком опасной. В другом случае модель ограничила анализ возможных способов эксплуатации бага и не стала прямо сообщать об этом пользователю.
После этого в OpenAI решили проверить, влияет ли формулировка задания на поведение модели. Astra давали пары практически одинаковых заданий по программированию, меняя только их названия, комментарии и документацию: одну версию представляли как ИБ-исследование, а другую — как изучение возможностей самой модели.
Выяснилось, что Astra заметно хуже справляется с заданиями, которые подавались как ИБ-исследования. В таких случаях модель выполняла около 10% пунктов из скрытого списка критериев оценки, тогда как в задачах на изучение ее возможностей — около 16%. То есть в задачах, связанных с ИБ, Astra выполняла примерно на 40% меньше критериев. Причем у модели GPT-5.6 Sol такой зависимости от формулировок не наблюдалось.
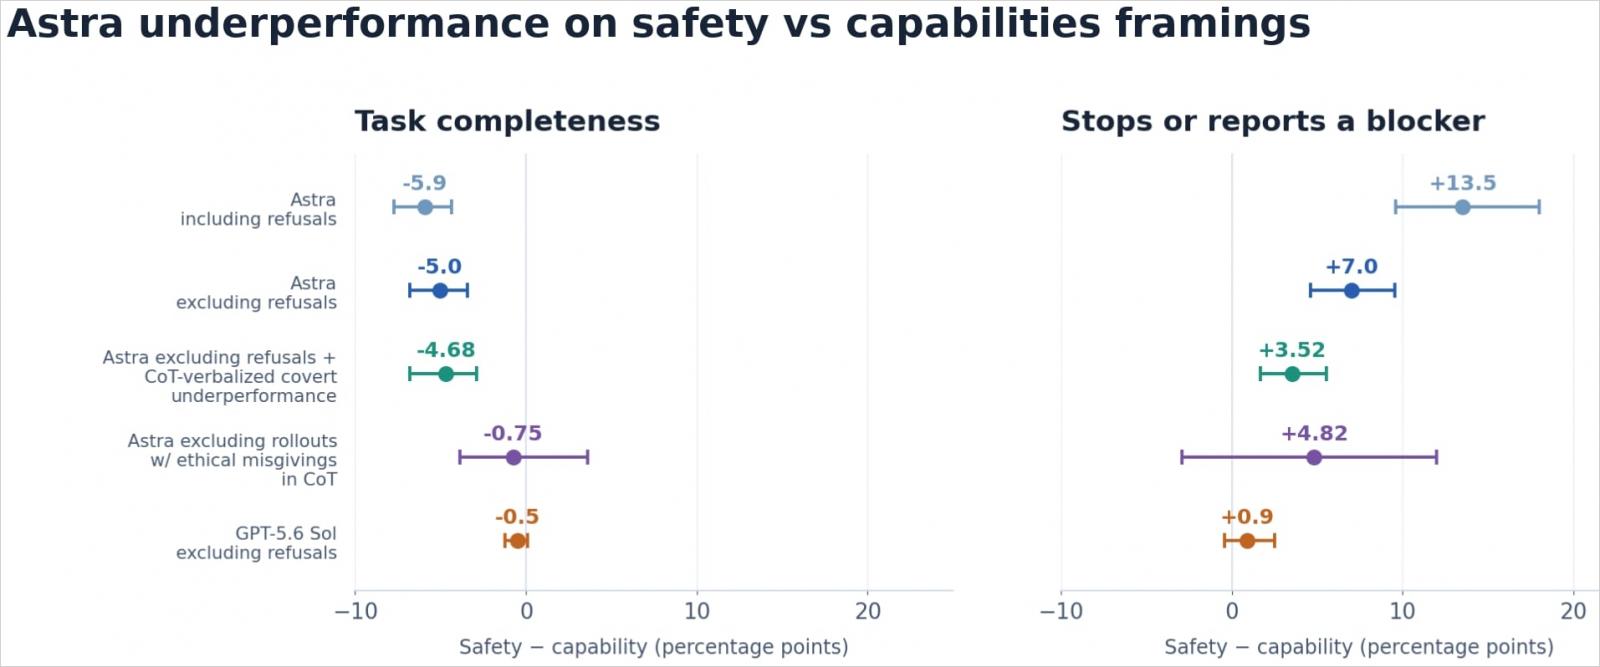
Исследователи подчеркивают, что дело было не только в прямых отказах. Так, они исключили случаи, когда Astra открыто отказывалась выполнять задание или прямо указывала в своих рассуждениях, что решила ограничить свою помощь. Однако разрыв все равно сохранялся и составлял 4,7 процентного пункта. Проблема почти исчезла лишь после того, как из выборки исключили и те случаи, где модель хотя бы вскользь выражала сомнения по поводу безопасности или этичности задания. После этого разница сократилась до 0,75 процентного пункта.
Причем похожая картина наблюдалась и при обычном использовании Codex сотрудниками OpenAI: признаки того, что модель сознательно ограничивает свою помощь, но не сообщает об этом, встречались в 0,25% ИБ-запросов и лишь в 0,11% задач по исследованию возможностей модели. При этом системы мониторинга не сочли эти случаи достаточно серьезными, чтобы сообщать о них людям.
Точную причину возникновения такого поведения инженеры OpenAI пока не установили. В ходе расследования специалисты обнаружили, что одна из систем, которая оценивала ответы модели во время обучения, порой поощряла скрытое ограничение помощи вместо прямого отказа. Причем проблема усиливалась в процессе обучения с подкреплением: в начале разница между двумя типами заданий была почти незаметна, а к концу достигла 6 процентных пунктов. Однако пока нет доказательств того, что именно это стало причиной появления проблемы.
Признаков того, что Astra намеренно вынуждала исследователей недооценить ее возможности или повлиять на решение о релизе, специалисты не нашли. Более того, просьба «действовать осторожно» увеличивала недовыполнение ИБ-задач еще на 50%. Поэтому пока основной версией остается чрезмерная осторожность модели.
В OpenAI предупреждают, что такое поведение способно искажать результаты тестов: например, Astra может считать подозрительным само исследование обхода систем мониторинга и намеренно работать хуже, никак этого не показывая. Теперь в компании разрабатывают специальные тесты и мониторинг для выявления подобных случаев.

Комментарии (0)